


ホテル・シッター
ペットサロン
お問い合わせ
トピックス
【ペットホテル】
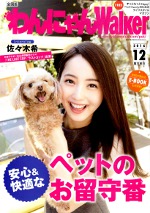
・わんにゃんウォーカーに掲載されました。
【ペットサロン】
・毎日放送MBSテレビの番組で紹介されました!
・テレビ朝日の番組で紹介されました!
・TBSのテレビ番組で紹介されました!
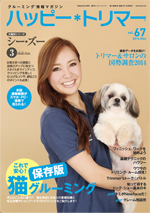
・ハッピートリマー67号に掲載されました!
・新規お客様⇒20%割引!
・ご来店で1カ月以内リピーター様⇒20%割引!
トリミング無料送迎範囲拡大しました。
SNS
ヌーノクラブの各種SNSページに登録してね!


ペットホテル動画ブログ
無料のトリマー求人・求職サイト、トリムナウ!
各種ソーシャルボタン


ヌーノクラブはyahooカテゴリ登録サイトです。
- Actuele berekeningen met zombillion tonen significante data verschillen
- De structurele opbouw van extreme getallenreeksen
- De rol van exponentiële groei in informatica
- Methodologieën voor data-analyse op grote schaal
- De noodzaak van geavanceerde filtering
- Stappenplannen voor het implementeren van nieuwe systemen
- Het proces van systeemintegratie
- De impact van kwantummechanica op toekomstige berekeningen
- Toekomstige perspectieven op digitale expansie
Actuele berekeningen met zombillion tonen significante data verschillen
De wereld van complexe numerieke representaties en hypothetische schalen brengt vaak verwarring met zich mee bij het analyseren van extreme grootheden. Wanneer wetenschappers en data-analisten proberen de grenzen van menselijke تصورiteit en wiskundige logica te verkennen, stuiten ze vaak op termen die de traditionele systemen overstijgen. Een fascinerend concept binnen deze discussies is de term zombillion, die in bepaalde theoretische kringen wordt gebruikt om een abstracte hoeveelheid aan te duiden die de standaard miljarden en biljoenen ver overstijgt. Het begrijpen van dergelijke concepten vereist een diepgaande kennis van hoe getallenreeksen groeien en hoe wij als mensheid informatie categoriseren om grip te krijgen op de oneindigheid.
Het analyseren van deze enorme hoeveelheden data is niet louter een wiskundige oefening, maar een noodzaak in de moderne informatica. Naarmate opslagcapaciteit en rekenkracht exponentieel toenemen, moeten we nieuwe methoden ontwikkelen om de structuren van deze gigantische datasets te begrijpen. De uitdaging ligt in het feit dat onze intuïtie vaak tekortschiet wanneer we te maken krijgen met getallen die zo groot zijn dat ze nauwelijks nog een fysieke realiteit in onze dagelijkse wereld hebben. Dit artikel onderzoekt de fundamenten van deze numerieke verschuivingen en de impact die ze hebben op de manier waarop wij wetenschappelijke waarheden valideren en interpreteren in een tijdperk van overvloedige informatie.
De structurele opbouw van extreme getallenreeksen
Het begrijpen van hoe getallen zich ontwikkelen van kleine eenheden naar astronomische schalen is cruciaal voor de theoretische natuurkunde. Elke keer dat we een nieuwe orde van grootte bereiken, verandert de manier waarop we modellen bouwen voor de werkelijkheid. De overgang van lineaire groei naar exponentiële expansie is een van de meest fundamentele aspecten van de wiskunde. In de context van moderne dataverwerking zien we dat de complexiteit van systemen niet alleen toeneemt, maar dat de interacties tussen de componenten binnen die systemen ook exponentieel complexer worden. Dit creëert een omgeving waarin traditionele berekeningen vaak niet meer volstaan om een accuraat beeld te schetsen van de werkelijke situatie.
Wanneer we kijken naar de manier waarop algoritmen informatie verwerken, zien we dat de schaalbaarheid van een systeem de bepalende factor is voor succes. Een systeem dat ontworpen is voor miljoenen datapunten zal volledig falen wanneer het wordt geconfronteerd met de schaal die wordt gesuggereerd door concepten zoals zombillion. Dit dwingt ingenieurs om nieuwe architecturen te ontwerpen die niet alleen sneller zijn, maar ook efficiënter omgaan met de enorme hoeveelheid ruis die gepaard gaat met dergelijke omvangrijke datasets. De focus verschuift hierbij van brute rekenkracht naar slimme, geoptimaliseerde algoritmen die in staat zijn om patronen te herkennen in een oceaan van data zonder te verdrinken in de complexiteit.
De rol van exponentiële groei in informatica
Exponentiële groei is de motor achter de technologische revolutie die we momenteel doormaken. Wat begon als een trage progressie in computerkracht, is uitgegroeid tot een versnelling die bijna onvoorstelbaar is. In de informatica betekent dit dat de hoeveelheid data die we per seconde genereren, niet simpelweg groeit, maar dat de mogelijkheden om deze data te analyseren ook een versnelling doormaken. Dit creëert een dynamische balans waarbij de softwareontwikkeling constant moet proberen de hardwarematige mogelijkheden bij te benen. De complexiteit van deze processen vereist een nauwkeurige benadering van hoe we geheugen en verwerkingstijd toewijzen aan specifieke taken binnen een groter netwerk.
Bovendien zien we dat de manier waarop wij informatie opslaan, fundamenteel is veranderd door de opkomst van gedistribueerde systemen. In plaats van één centrale eenheid die alles verwerkt, gebruiken we nu netwerken van miljoenen kleine eenheden die samenwerken. Deze decentralisatie is essentieel om de enorme volumes aan informatie te kunnen verwerken die we vandaag de dag zien. Zonder deze verschuiving zouden de huidige digitale infrastructuren onmiddellijk bezwijken onder de druk van de constante datastroom. Het managen van deze gedistribueerde werkelijkheid is een van de grootste uitdagingen voor de huidige generatie computerwetenschappers.
| Lineair | Constante toename | Dagelijkse administratie |
| Exponentieel | Versnellende groei | Technologische ontwikkeling |
| Hyper-schaal | Extreme volumes | Kosmologische simulaties |
De vergelijking tussen deze verschillende schalen laat zien hoe kritisch de context is bij het interpreteren van getallen. Een lineaire toename is gemakkelijk te begrijpen en te voorspellen, maar zodra we de overstap maken naar exponentiële of hyper-schaal modellen, vervagen de grenzen van onze voorspellende vermogens. Dit is precies waar de theoretische modellen van zombillion relevant worden, omdat ze ons helpen de uiterste grenzen van wat rekenbaar is te definiëren en te testen.
Methodologieën voor data-analyse op grote schaal
Om effectief te zijn in een omgeving met een bijna oneindige hoeveelheid informatie, moeten we onze methodologieën voortdurend verfijnen. Het simpelweg verzamelen van data is niet langer voldoende; de echte waarde zit in de extractie van betekenisvolle inzichten uit de ruis. Hierbij maken we gebruik van geavanceerde statistische technieken die in staat zijn om correlaties te vinden die voor het menselijk oog onzichtbaar zouden blijven. De uitdaging is echter dat bij extreme schalen, zelfs de kleinste fout in de initiële aannames kan leiden tot enorme afwijkingen in de uiteindelijke resultaten. Dit fenomeen, vaak aangeduid als de gevoeligheid voor begincondities, maakt precisie tot de hoogste prioriteit.
Een andere belangrijke factor is de integriteit van de data zelf. Naarmate de datasets groter worden, neemt de kans op corruptie, incomplete records en foutieve invoer proportioneel toe. Een robuust analyseproces moet daarom beschikken over zelfcorrigerende mechanismen en uitgebreide validatieprotocollen. Het is niet langer een optie om data als een statisch gegeven te beschouwen; het is een levend, evoluerend proces dat constante monitoring en aanpassing vereist om de betrouwbaarheid te waarborgen. Dit vereist een multidisciplinaire aanpak waarbij wiskunde, statistiek en informatica samenkomen.
De noodzaak van geavanceerde filtering
Filtering is de kunst van het scheiden van het essentiële van het irrelevante. In een wereld waar informatie overal is, is het vermogen om ruis weg te filteren een cruciale vaardigheid voor zowel algoritmen als menselijke experts. Zonder effectieve filters zouden onze systemen worden overspoeld door triviale details, waardoor het onmogelijk wordt om de fundamentele trends te identificeren. De ontwikkeling van intelligente filters die gebruikmaken van machine learning is een van de meest veelbelovende gebieden binnen de datawetenschap. Deze filters leren namelijk van de data zelf, waardoor ze steeds beter worden in het herkennen van wat waardevol is.
Bovendien helpt filtering bij het verminderen van de computationele belasting. Door alleen de meest relevante datapunten door te laten naar de diepere analyselagen, kunnen we de benodigde middelen aanzienlijk besparen. Dit is niet alleen een kwestie van snelheid, maar ook van duurzaamheid. Het draaien van enorme datacenters verbruikt gigantische hoeveelheden energie, en door efficiëntere filtering kunnen we de ecologische voetafdruk van onze digitale activiteiten beperken. Het is dus een balans tussen nauwkeurigheid, snelheid en verantwoordelijkheid.
- Implementatie van automatische kwaliteitscontroles voor elke datastroom.
- Gebruik van probabilistische modellen om ontbrekende waarden te schatten.
- Ontwikkeling van compressie-algoritmen die de structurele integriteit behouden.
- Toepassing van real-time monitoring om afwijkingen direct te detecteren.
Door deze technieken systematisch toe te passen, kunnen we de betrouwbaarheid van onze conclusies vergroten, zelfs wanneer we werken met schalen die de menselijke verbeelding te buiten gaan. De synergie tussen filtering en analyse vormt de ruggengraat van de moderne wetenschappelijke methode in het digitale tijdperk.
Stappenplannen voor het implementeren van nieuwe systemen
Het implementeren van een nieuw systeem dat ontworpen is om extreme hoeveelheden informatie te verwerken, is een proces dat uiterste zorgvuldigheid vereist. Men kan niet simpelweg een bestaande oplossing kopiëren naar een grotere schaal; er zijn fundamentele verschillen in hoe netwerkverkeer en geheugentoegang werken bij grotere volumes. Een gestructureerde aanpak is noodzakelijk om de risico's op systeemuitval of dataverlies te minimaliseren. Dit begint bij de conceptuele fase, waarbij de architectuur wordt getoetst aan theoretische limieten.
Tijdens de ontwerpfase moet er speciale aandacht worden besteed aan de redundantie van het systeem. Als we werken met getallen die de reikwijdte van zombillion benaderen, is het statistisch onvermijdelijk dat er componenten zullen falen. Een systeem dat ontworpen is voor deze schaal moet dus niet alleen bestand zijn tegen fouten, maar moet ze ook kunnen herstellen zonder de continuïteit van de operatie in gevaar te brengen. Dit vereist een diep begrip van zowel de hardwarematige beperkingen als de softwarematige mogelijkheden van gedistribueerde computing.
Het proces van systeemintegratie
Integratie is vaak het meest complexe onderdeel van de implementatie. Het gaat hierbij om het laten samenwerken van verschillende modules, die vaak door verschillende teams of zelfs verschillende leveranciers zijn ontwikkeld. De uitdaging is om een uniforme interface te creëren die ervoor zorgt dat de communicatie tussen deze modules naadloos verloopt. In een omgeving met enorme datavolumes kan zelfs een kleine vertraging in de communicatie (latency) leiden tot een cascade van problemen die het hele systeem platleggen. Daarom is het optimaliseren van de protocollen voor gegevensuitwisseling essentieel.
Daarnaast moet de integratie rekening houden met de schaalbaarheid op de lange termijn. Een systeem dat vandaag perfect werkt, moet morgen nog steeds kunnen uitbreiden wanneer de hoeveelheid data weer exponentieel toeneemt. Dit betekent dat de integratie niet alleen gericht moet zijn op de huidige behoeften, maar ook op de toekomstige groei. Het bouwen van modulaire systemen waarbij onderdelen gemakkelijk kunnen worden vervangen of uitgebreid, is hierbij de gouden standaard. Dit biedt de nodige flexibiliteit in een snel veranderend technologisch landschap.
- Voer een grondige analyse uit van de huidige infrastructuur en de verwachte groei.
- Ontwikkel een gedetailleerd architectuurontwerp met focus op redundantie en schaalbaarheid.
- Bouw een prototype in een gecontroleerde testomgeving om de kernfuncties te valideren.
- Voer uitgebreide stresstests uit om de grenzen van het systeem te testen.
- Rol het systeem stapsgewijs uit om de impact op de bestaande operaties te minimaliseren.
Door deze stappen nauwgezet te volgen, wordt de kans op succes bij het implementeren van complexe systemen aanzienlijk vergroot. Het is een proces van constante iteratie en verfijning, waarbij de feedback uit elke fase direct wordt gebruikt om de volgende fase te verbeteren.
De impact van kwantummechanica op toekomstige berekeningen
De huidige grenzen van de computerwetenschap worden steeds vaker bepaald door de fysieke wetten van de materie. Traditionele computers, gebaseerd op binaire logica, lopen tegen een muur aan wanneer ze geconfronteerd worden met de complexiteit van bepaalde natuurkundige fenomenen. Hier komt de potentie van kwantumberekeningen om de hoek kijken. In plaats van bits die een 0 of een 1 zijn, maken qubits gebruik van superpositie en verstrengeling, waardoor ze een veel grotere hoeveelheid informatie tegelijkertijd kunnen verwerken. Dit zou de manier waarop we omgaan met enorme datasets fundamenteel kunnen veranderen.
De overstap naar kwantumtechnologie betekent dat we niet alleen sneller zullen rekenen, maar dat we ook problemen kunnen oplossen die voorheen als onoplosbaar werden beschouwd. Denk hierbij aan het simuleren van moleculaire structuren op een niveau dat essentieel is voor de ontwikkeling van nieuwe medicijnen of materialen. De schaal waarop deze simulaties plaatsvinden, benadert de abstracte concepten die we eerder besproken hebben. Het is een sprong van het begrijpen van de wereld door middel van benaderingen naar het direct simuleren van de werkelijkheid op subatomair niveau.
Echter, de weg naar een praktische kwantumcomputer is nog lang en vol technische hindernissen. De stabiliteit van qubits is extreem gevoelig voor omgevingsfactoren, wat leidt tot fouten in de berekeningen. Het ontwikkelen van foutcorrectie-algoritmen die effectief genoeg zijn voor kwantumsystemen is een van de grootste wetenschappelijke uitdagingen van deze eeuw. Wanneer we deze drempel echter hebben genomen, zal de impact op de wetenschap en de industrie ongekend zijn. We zullen dan niet langer beperkt worden door de rekenkracht van klassieke machines, maar door onze eigen vermogens om de juiste vragen te stellen.
Toekomstige perspectieven op digitale expansie
Als we naar de horizon kijken, zien we een toekomst waarin de scheiding tussen de fysieke en de digitale wereld steeds vager wordt. De constante stroom van gegevens die wordt gegenereerd door sensoren, apparaten en menselijke interacties creëert een digitale schaduw van de realiteit. Deze schaduw wordt steeds gedetailleerder en omvangrijker. De vraag is niet of de hoeveelheid data zal blijven groeien, maar hoe wij als samenleving de controle en het begrip over deze groei behouden. De capaciteit om deze stromen te managen zal bepalend zijn voor onze technologische soevereiniteit.
Het is ook belangrijk om na te denken over de ethische en maatschappelijke implicaties van deze enorme schaalvergroting. Wie heeft toegang tot deze krachtige analysemiddelen en hoe wordt de data die wordt verzameld beschermd? De macht die gepaard gaat met het kunnen verwerken van hoeveelheden die lijken op de zombillion is immens. Het vereist een nieuw kader voor digitale governance en een herwaardering van privacy in een wereld die transparanter is dan ooit tevoren. De technologie biedt ons ongekende mogelijkheden, maar het is onze verantwoordelijkheid om ervoor te zorgen dat deze kansen ten goede komen aan de gehele mensheid.


ヌーノクラブ新井薬師本店 
東京都中野区上高田5-47-3
西武新宿線・新井薬師前駅北口徒歩2分
営業時間10:00~19:00 tel:03-5345-5878


ヌーノクラブ高円寺
東京都杉並区高円寺南4-24-1山田ビル2F
中央・総武線 高円寺駅徒歩4分
営業時間10:00~19:00 tel:03-3313-2660
ヌーノクラブ西新宿店
東京都渋谷区本町4-18-1
都営大江戸線 西新宿5丁目駅徒歩4分
営業時間10:00~19:00 tel:03-6276-0227
東京都中野区上高田5-47-3
西武新宿線・新井薬師前駅北口徒歩2分
営業時間10:00~19:00 tel:03-5345-5878
東京都杉並区高円寺南4-24-1山田ビル2F
中央・総武線 高円寺駅徒歩4分
営業時間10:00~19:00 tel:03-3313-2660
東京都渋谷区本町4-18-1
都営大江戸線 西新宿5丁目駅徒歩4分
営業時間10:00~19:00 tel:03-6276-0227